没去过你家,也不耽误帮你叠被子。
9 月 17 日,Figure AI 发布了新一代模型 Helix 2.5,在 30 个真实的湾区民宅里做了一次零样本测试。
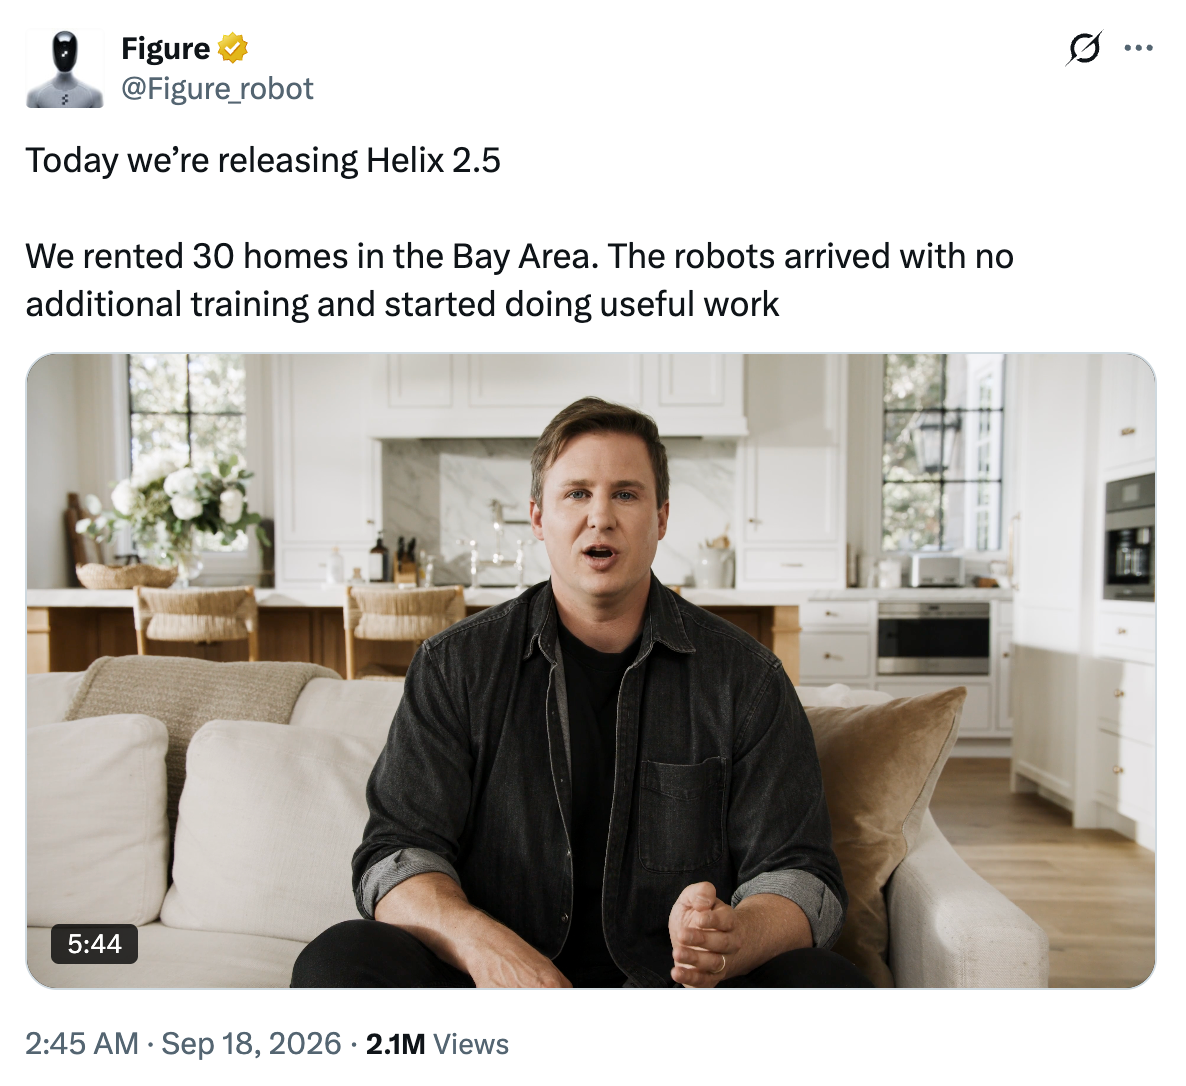
我的很多朋友都观看了这段视频,他们感到习以为常,「这看起来不至于令人惊叹,不就是机器人叠毛巾、整理床铺以及捡东西而已嘛。」
是的,我们之前已经看到机器人能够整理床铺、折叠毛巾以及打扫房间。不过我们没见过的是,这些机器人把训练好的行为模式,直接搬进 30 个从未打过交道的家庭——面对完全陌生的物体、完全陌生的房间布局,事先没有任何数据采集,也没有做任何针对性微调。
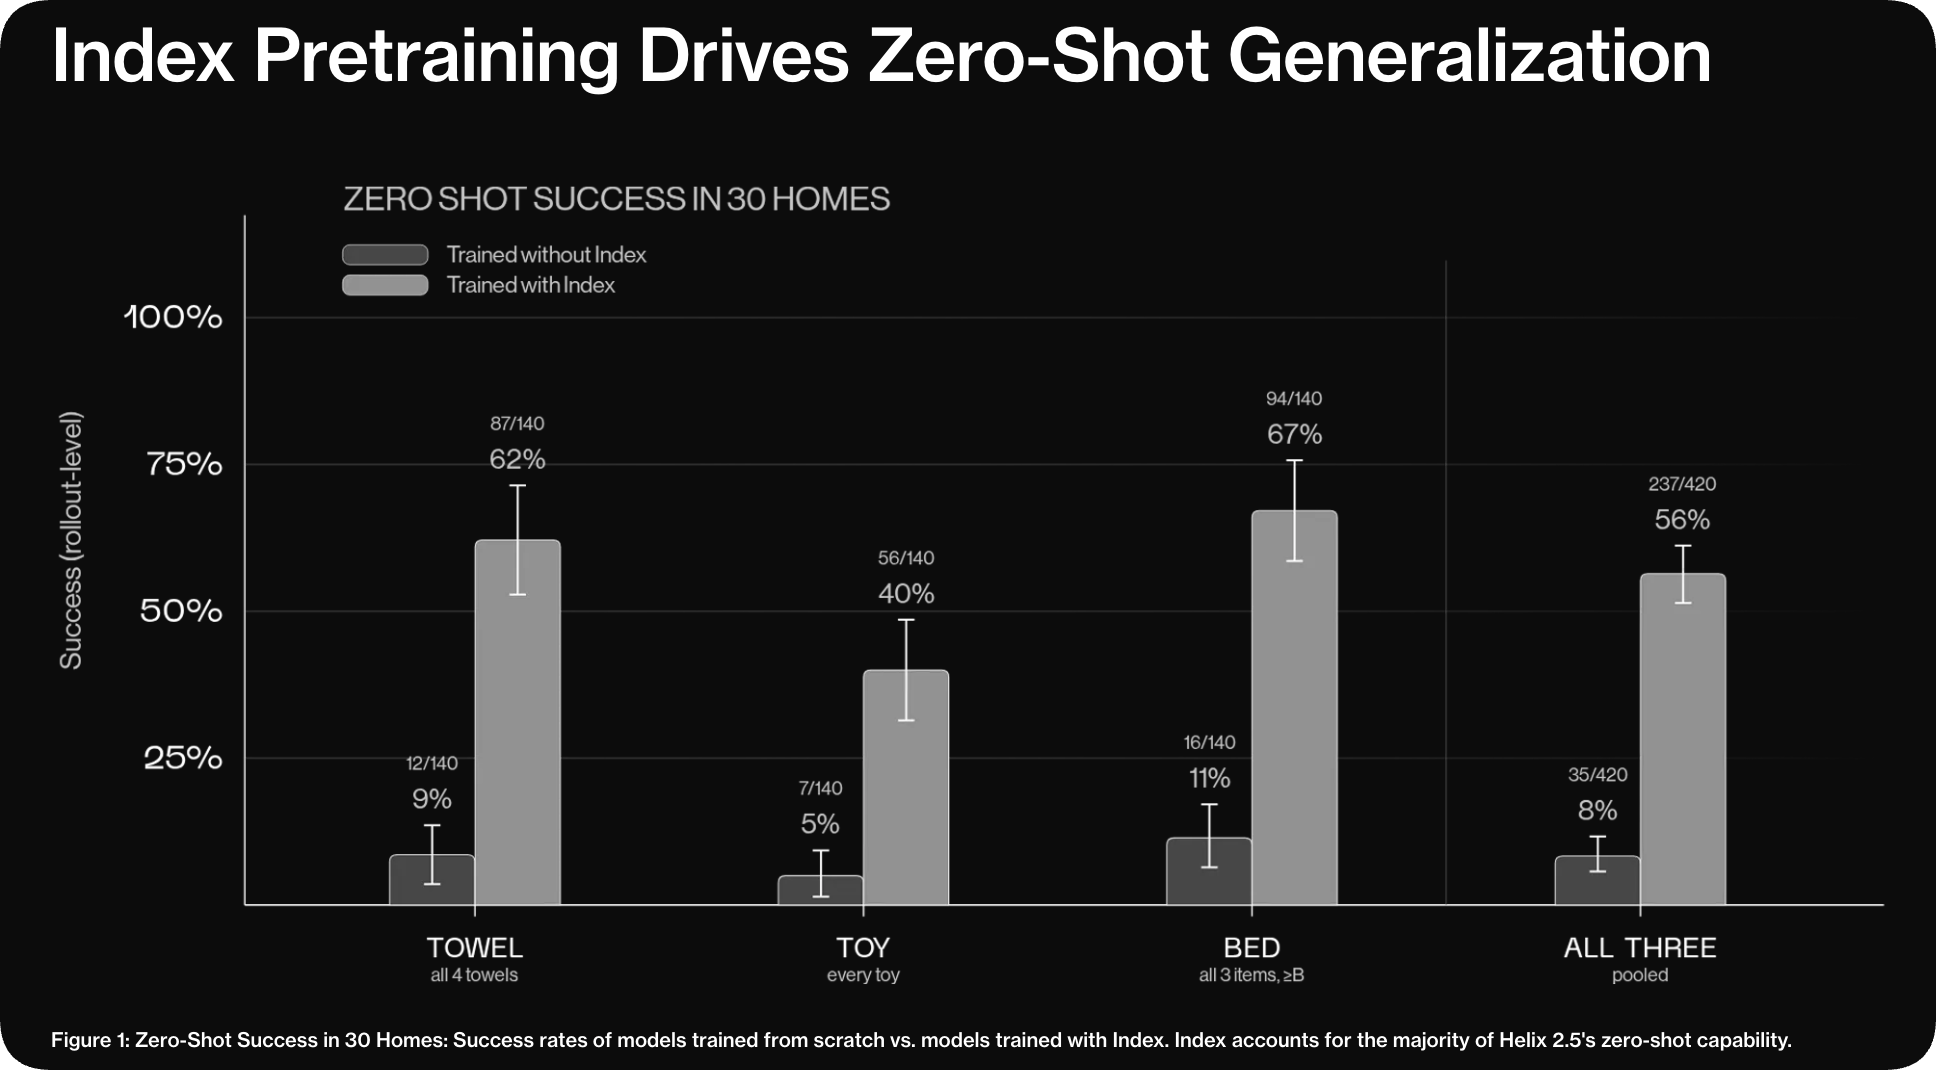
在 420 次试验里有 237 次成功,零样本成功率为 56%,评测过程为盲测,且没有任何单一评测任务在 Index 预训练数据中的占比超过 1.90%。
这意味着机器人几乎是「凭空」应对每一个新家庭。作为参照,同样硬件、同样任务数据、只是没有经过 Index 预训练的策略,成功率只有 9%。
随着预训练数据的增加,机器人的表现呈现出可预测的、类似语言模型的比例关系。在其他条件不变的情况下,Index 的预训练让零样本任务的成功率从 9% 提升到了 56%,整体成功率则提升了 522%。
更引人注意的是,Figure 还把 Helix 2.5 和自己上一代模型 Helix 02 放在一起比较:后者需要先在目标场地采集数据才能训练,而 Helix 2.5 仅用一半的适应数据量,就在 30 个从未见过的家庭里追平了 Helix 02 在单一场地的成功率。
这次真的不一样吗
很多人对家用机器人最早的印象,来自半个世纪前的动画片《杰森一家》。里面那个叫 Rosey 的机器人管家,围裙拖把一应俱全,做饭打扫铺床样样能干。
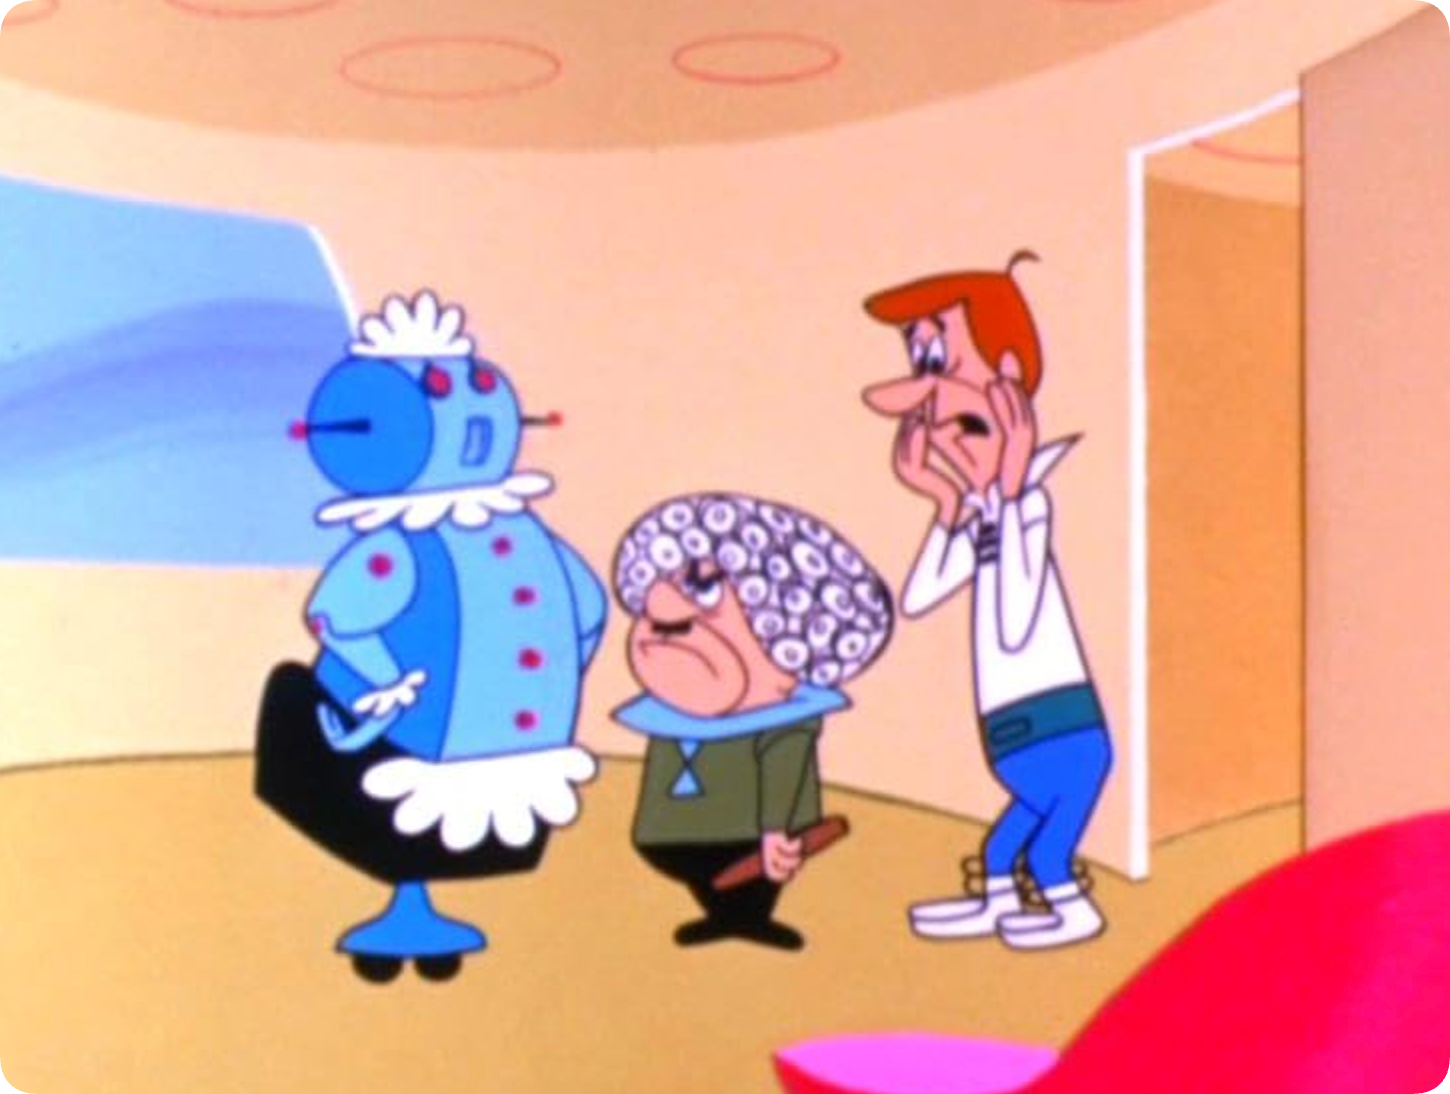
▲Rosey the Robot
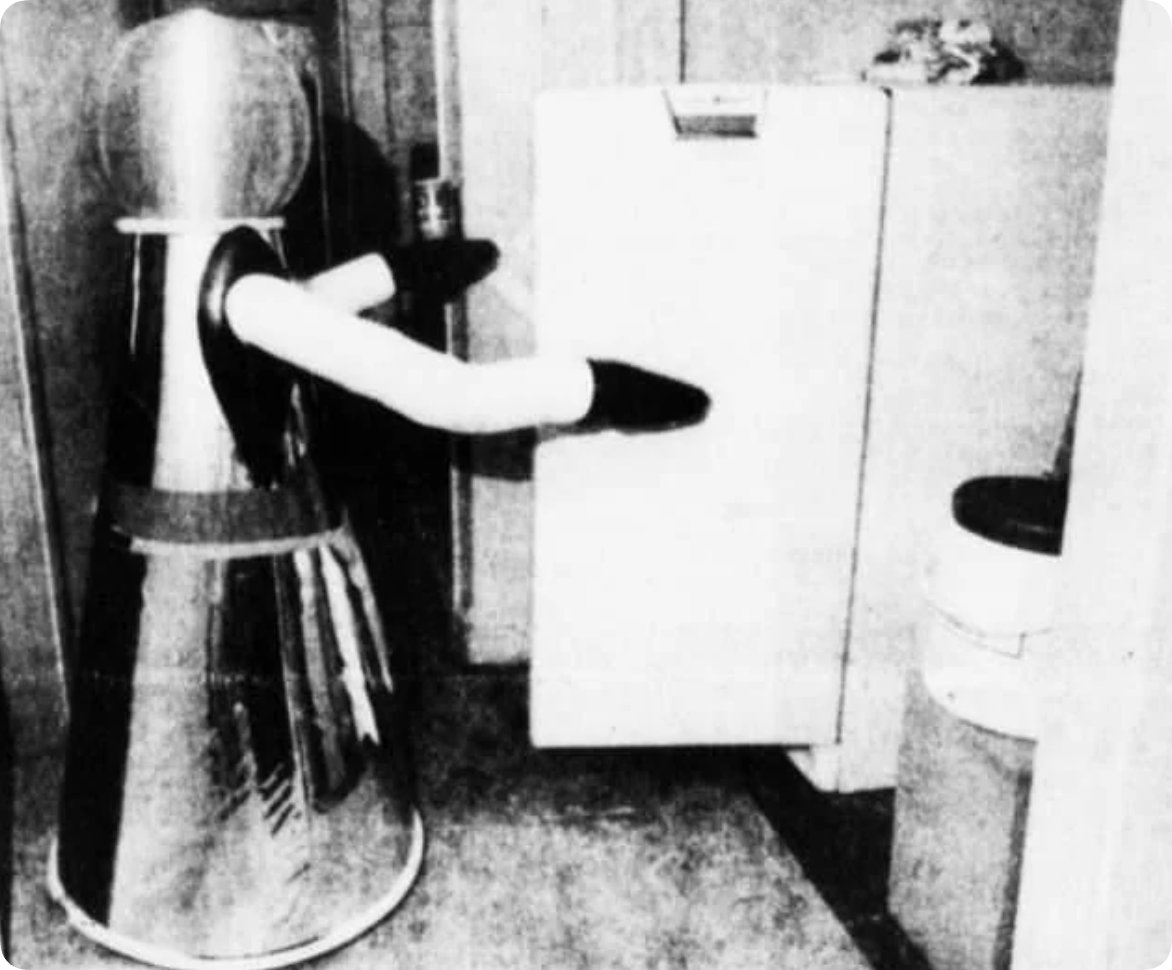
Rosey 在后来的几十年里激励了无数机器人设计。例如,像 Miss Honeywell ——她是一名魔术师的人类助手,曾经销售过各种家电和电脑产品——与 Rosey 非常相似,甚至连颜色搭配都一模一样。
到了 1970 年代和 80 年代,人们对家用机器人的期望越来越高,不过随之出现的也有许多假冒公司。似乎每一种新技术都会吸引那些投机取巧的人。
20 世纪的机器人也不例外,其中最著名的骗局就是来自新泽西州的 Quasar Industries 公司,他们在 1970 年代承诺推出了家用机器人。然而,Klatu 这款家用机器人甚至无法完成 Quasar 所宣传的半数任务:打扫卫生、修剪草坪,甚至遛狗……不过,这并没有阻止该公司继续宣称自己已经迈入了未来时代。
半个世纪过去,家用机器人的叙事似乎又走到了同一个路口。
对人而言,换一张床不至于忘记怎么铺被子。对机器人而言,床的高度、墙边的空隙、被角垂落的位置,都可能让熟悉的动作瞬间失效。如果每进入一个家庭都得有人重新采集示范、调整模型,那么机器人卖出去之后,训练工作才刚刚开始。
这也是过去几年里,几乎所有「看起来很厉害」的家用机器人演示背后共同的短板:特斯拉的 Optimus、1X 的 Neo,无一例外都要依赖大量场地专属数据或人工远程操作才能完成任务。
Figure 今年 1 月发布的上一代模型 Helix 02,可以完成卸洗碗机这类连续几十步的长时任务,但也需要先在目标场地采集数据。
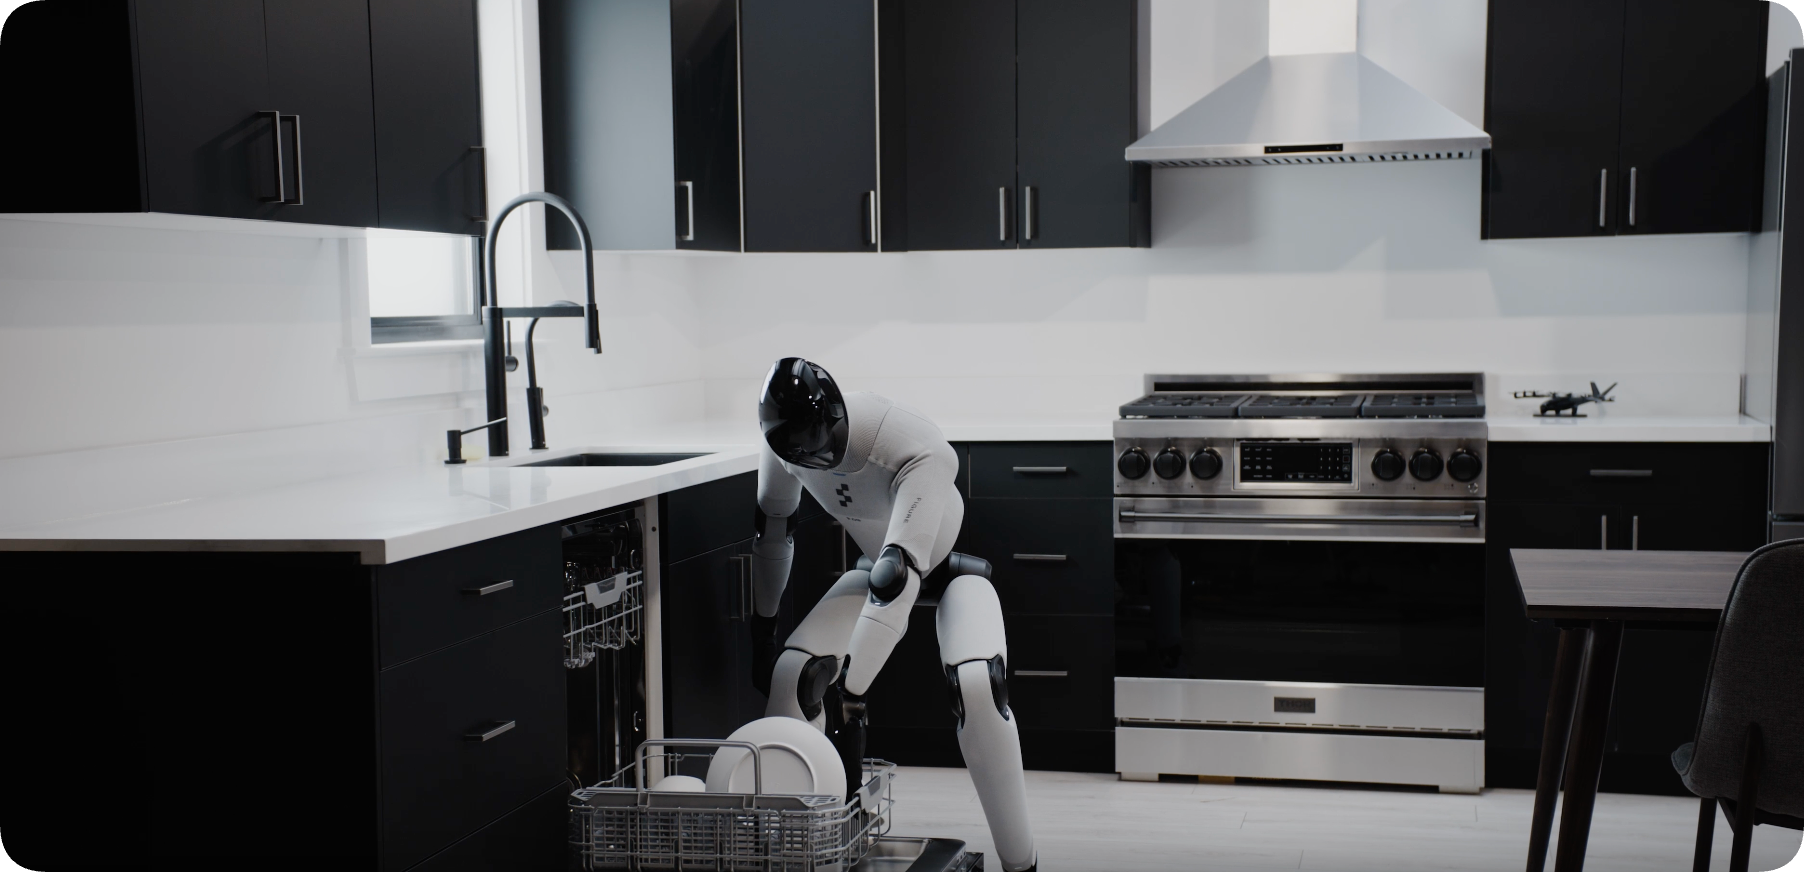
Helix 2.5 想回答一个更难的问题,机器人能不能走进一个从没见过的家,直接开始干活,不需要主人先配合录一遍自己家的样子。
Figure 在评测前专门把要用到的玩具、毛巾和床品挑出来单独存放,先由一个 AI 模型初筛、再由人工复核,确认它们没有出现在任何任务训练数据里;30 个住宅也保留了各自原有的沙发、床铺和折叠台面,没有做任何针对评测的改造。
CEO Brett Adcock 说,这是「我们迄今做过最重要的项目」。他和 AI 总监 Corey Lynch 在发布视频里强调,机器人在 30 个家庭中「每一个都记录到了成功」。
近几年比较扎实的项目,大多依赖在特定场地反复采集和调优。Helix 2.5 第一次让人看到,随着预训练数据规模增长,机器人在陌生环境里的表现呈现出某种可以预测的比例关系,而不是每换一个房间就要从零开始。
机器人先向人类借一点经验
支撑这次变化的 Index,看起来更像一门数据采集生意。
Figure 早在今年 5 月就以另一款应用的形式低调上线了数据采集入口,直到 8 月 25 日才正式以 Index 之名公开亮相,并称其为「迄今最庞大、最多样的机器人训练数据集」。
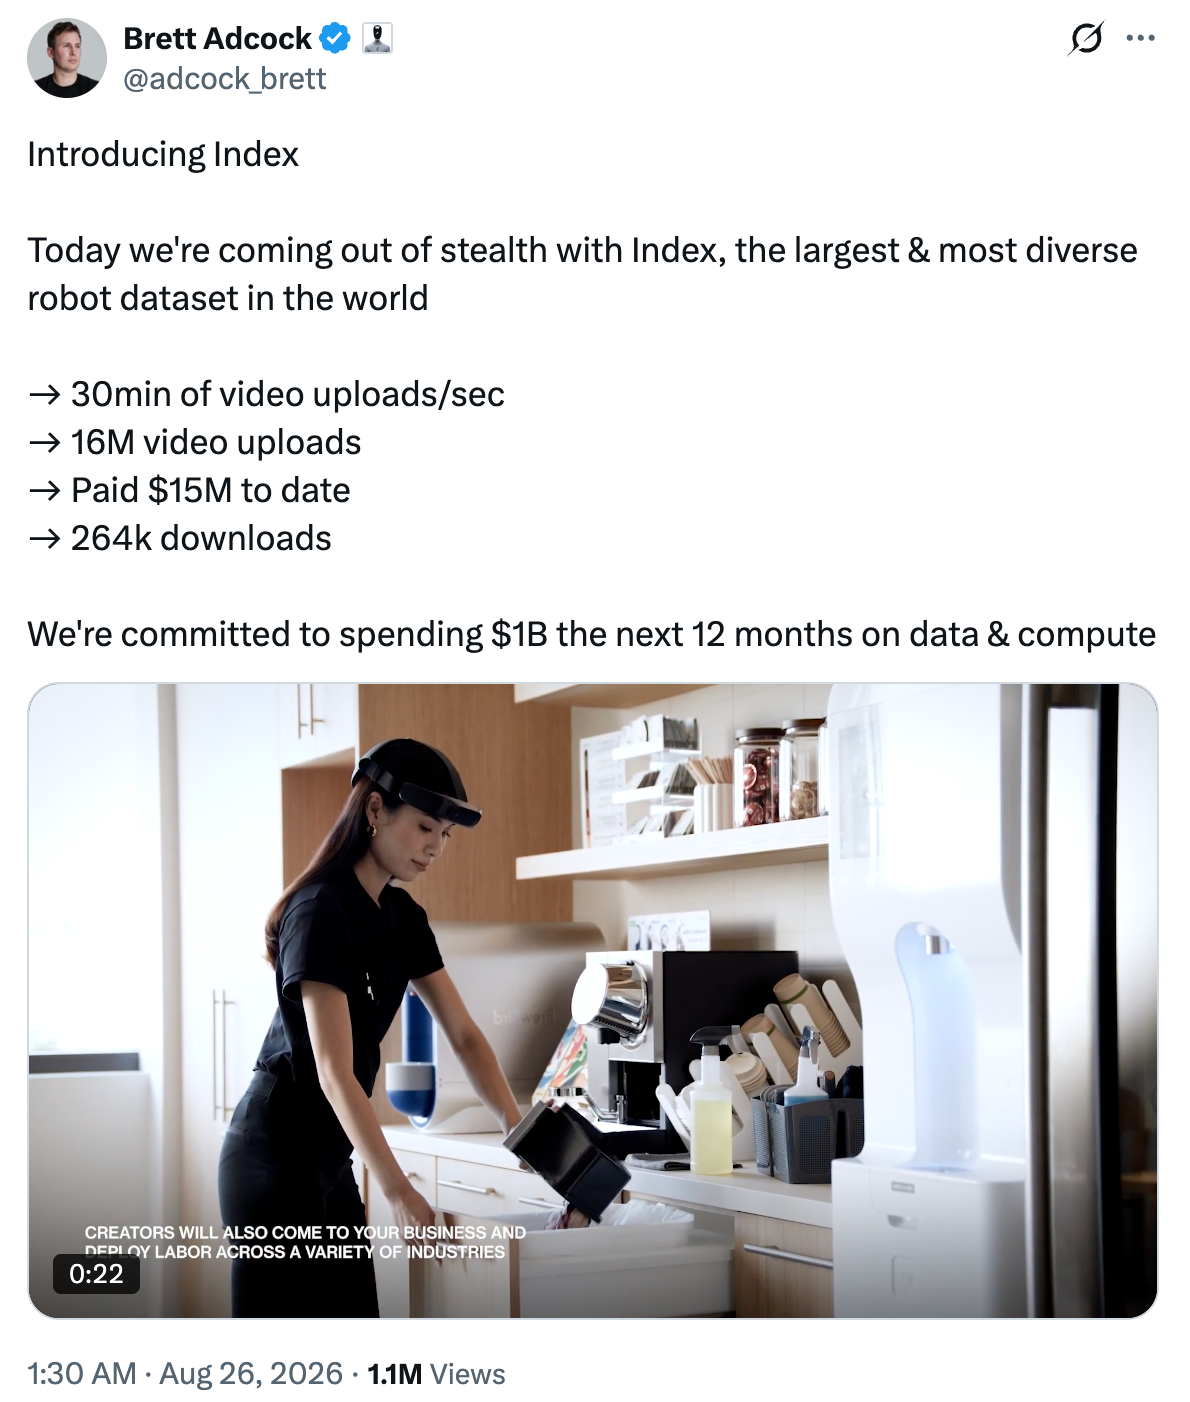
据官方披露,Index 上线时已有 26.4 万次下载,覆盖 108 个国家,每周活跃创作者超过 4.4 万人,累计上传视频超过 1600 万条;上传速度一度达到每秒钟 30 分钟的新视频,相当于每天有 4.9 年人类工作量涌入系统,到 9 月初这一速度进一步提高到每秒 35 分钟。
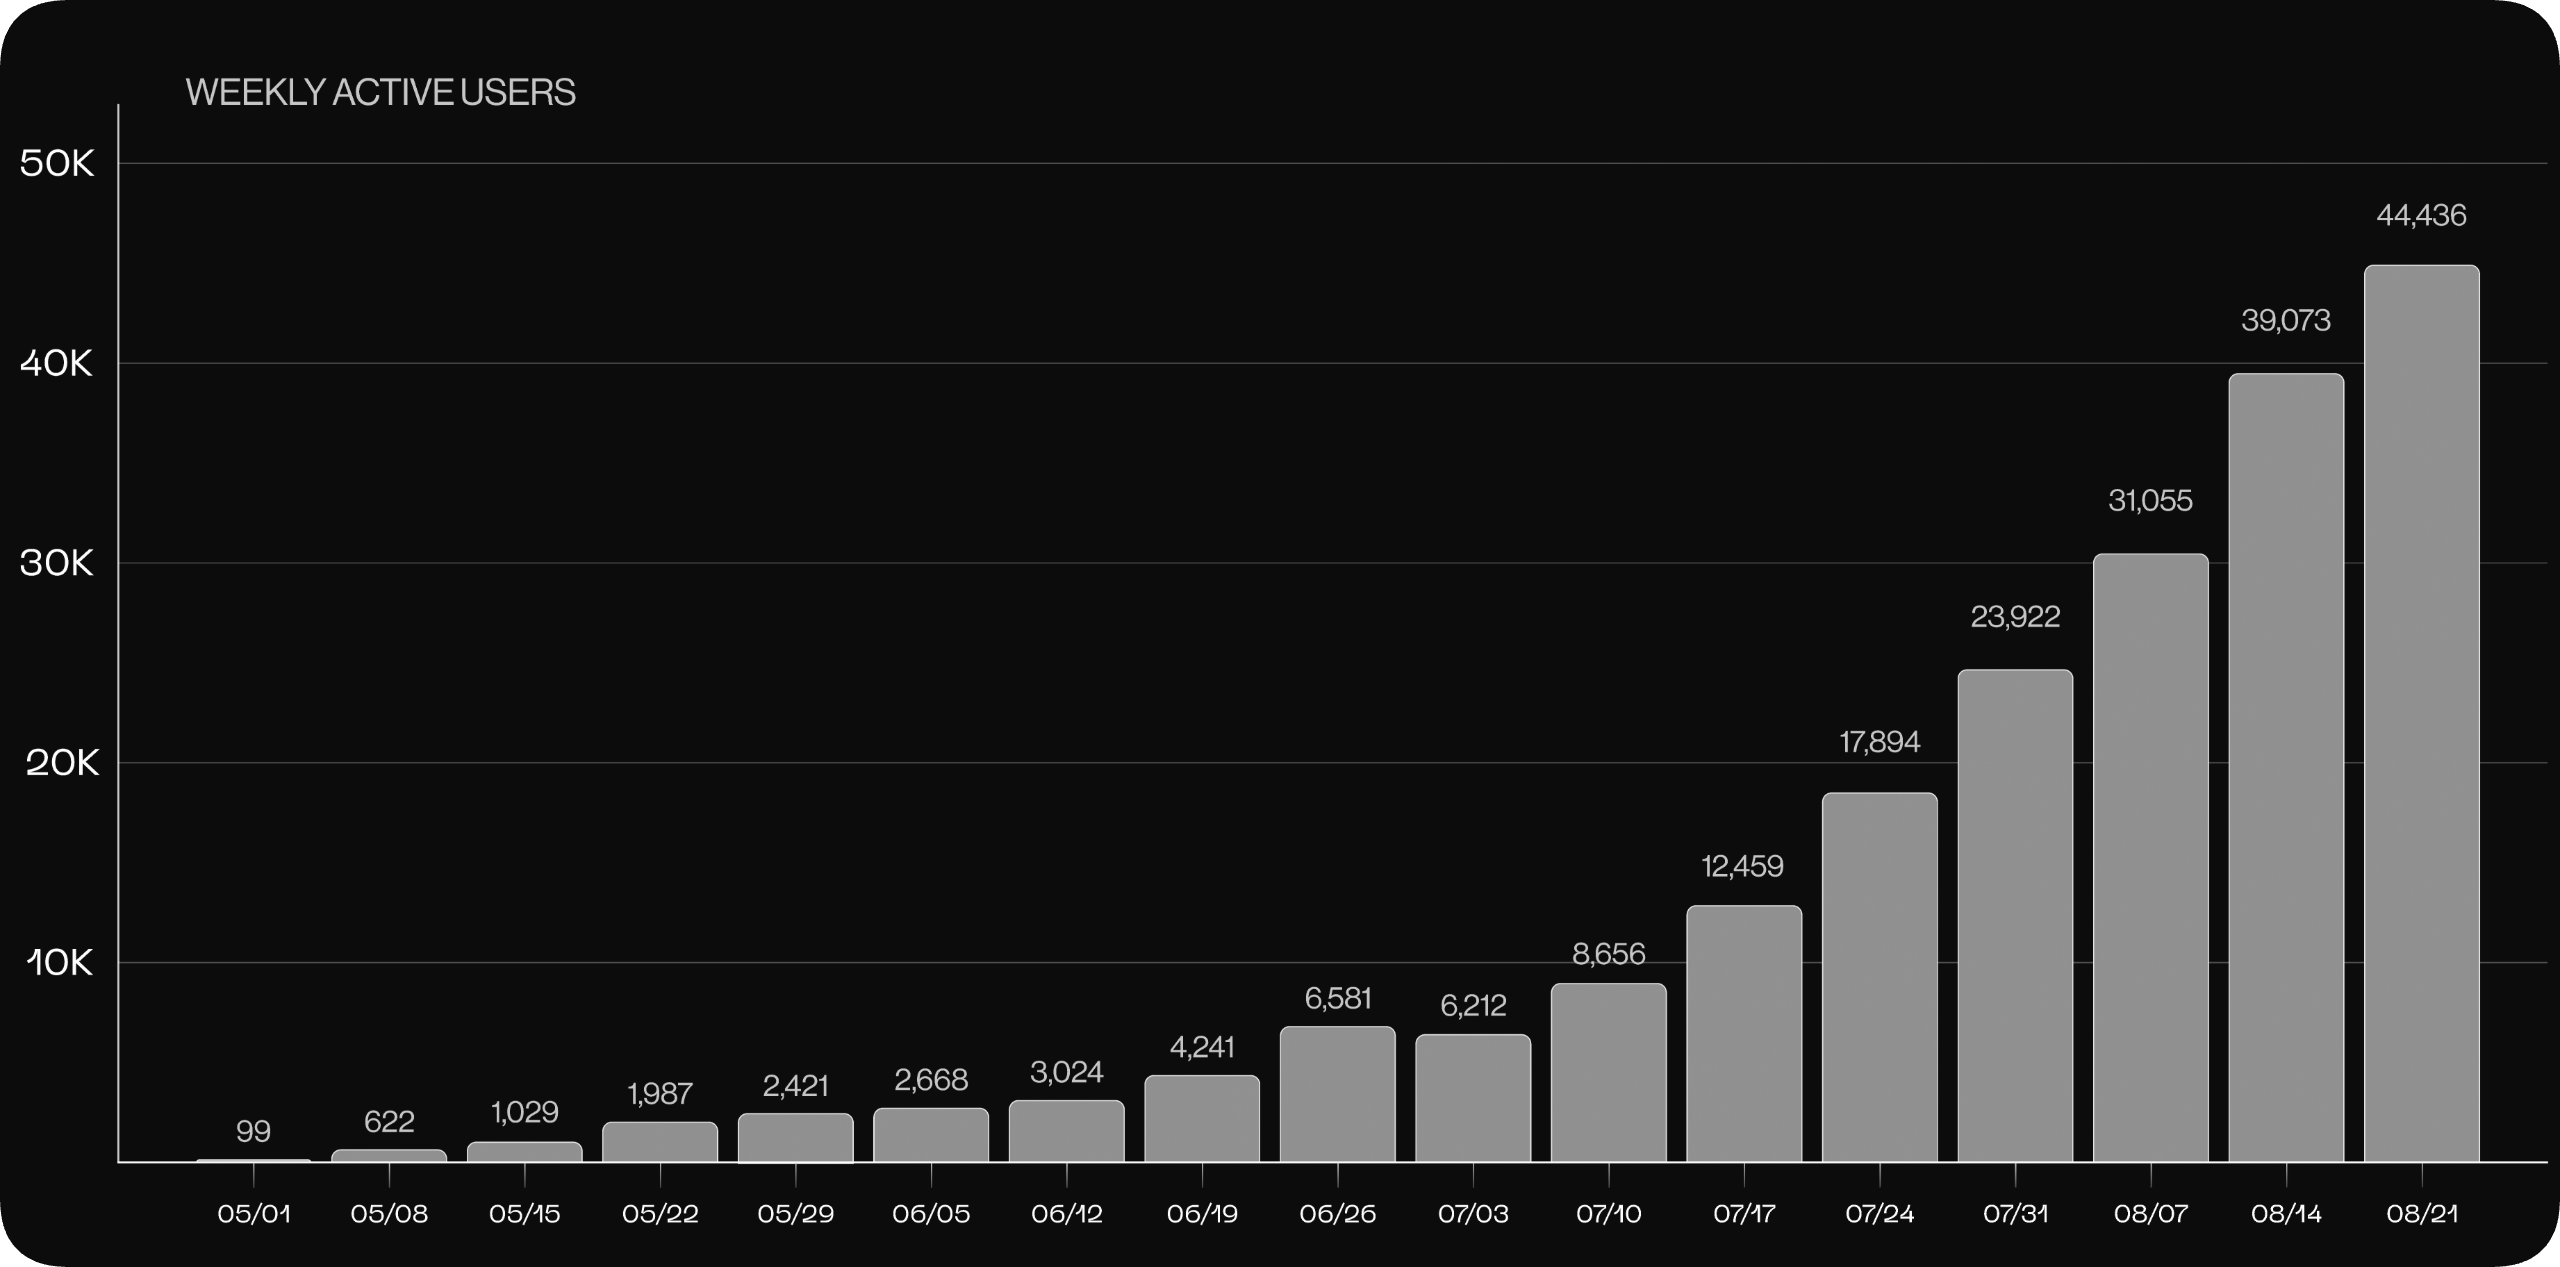
Figure 已经为此向「创作者」支付了 1500 万美元,并计划在未来 12 个月投入超过 10 亿美元用于数据和算力,把采集规模再扩大 100 倍。
每 1000 小时收集到的数据里,包含 373 个不重复任务、1146 个不重复操作对象和 116 个不重复环境。
Figure 披露,数据还要经过筛选、反作弊检查、去重、分布再平衡和文字标注这五道工序,才能进入训练环节。
Index 之于人形机器人,多少有点像早期互联网文本语料之于大语言模型的意思。沿着这个类比,人类日常行为有机会成为机器人的基础教材。过去需要为一处场地重复收集的经验,或许能被提前学到,并带进下一处环境。
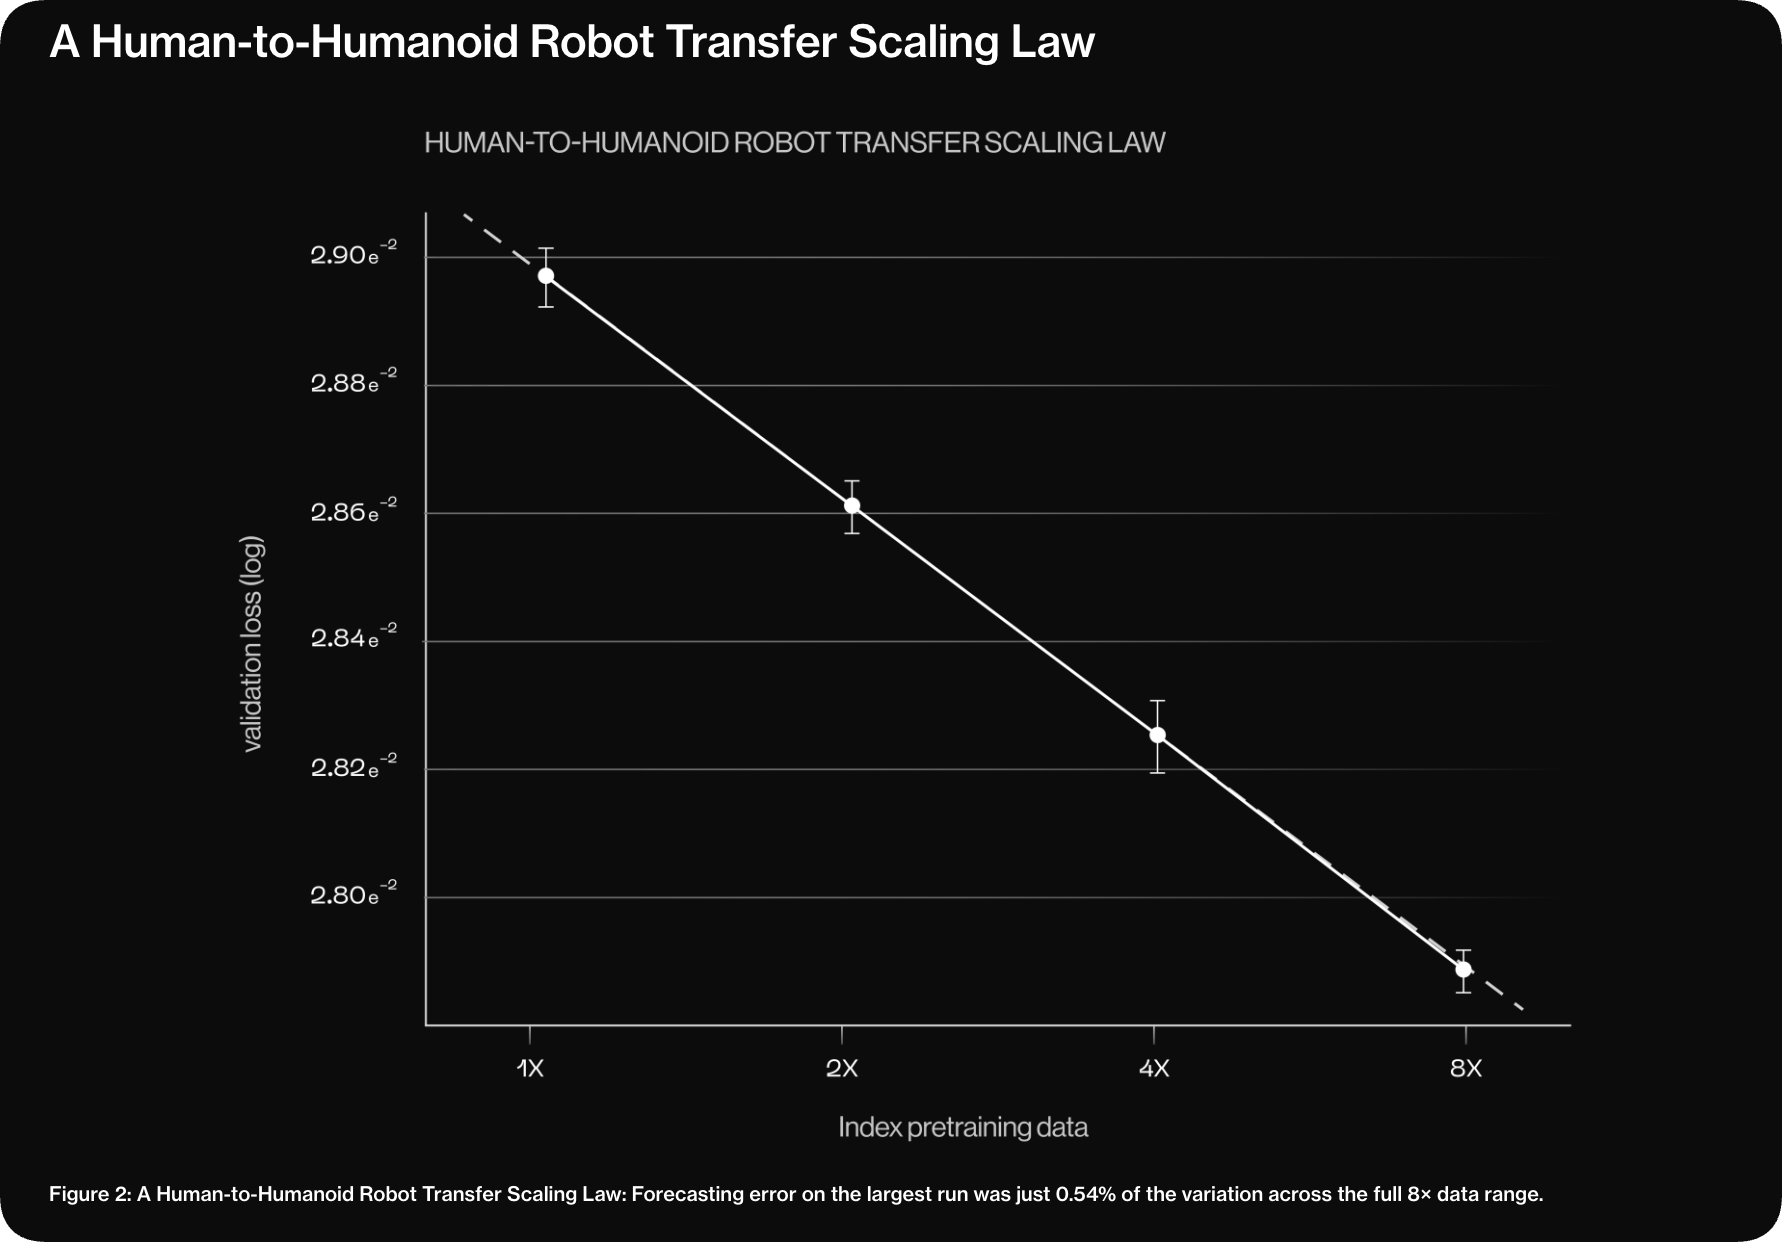
在模型规模和下游训练条件固定时,将 Index 预训练数据逐次翻倍,机器人动作预测误差会规律性下降。实验使用了四档数据规模,最大与最小相差 8 倍,误差曲线平滑到可以提前用小规模实验预测出最大规模训练的损失值,偏差只有整体波动范围的 0.54%。公司把这称作人类到人形机器人迁移的一条缩放定律。
其他公司也在寻找扩大经验来源的方法。1X 的 Neo 在今年 2 月开始面向家庭预订,售价 2 万美元,但几乎所有稍微复杂一点的动作,例如从冰箱里取水、往洗碗机里放餐具、叠一件毛衣,都要靠公司内部代号「Turing」的远程操作员戴着 VR 设备实时接管才能完成。
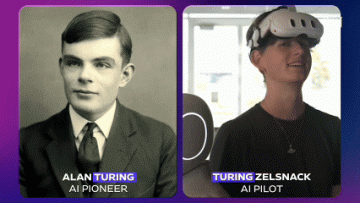
1X 把这些远程操作数据和家庭日常视频一起喂给今年 1 月发布的世界模型,希望以此逐步降低对人工接管的依赖。
特斯拉的 Optimus 则更依赖大规模人类遥操作,让操作员戴着传感设备完成分拣、使用电动工具之类的动作,再把这些轨迹交给神经网络去模仿和优化。
相比之下,Figure 先让模型从海量人类视频里学会一般性的行为模式,再用少量任务数据把它适配到具体动作上,理论上不再需要为每一个新家庭单独派人采集或远程接管。
叠毛巾之后,还有真实生活
叠毛巾看起来无聊,是因为我们太熟悉了。观众通常从动作是否新奇来判断进展。研究者在解释泛化,屏幕前的人只看见又叠好了一条毛巾。
我个人唯一感到失望的是,测试中只有三个任务。我希望能有更多任务,比如擦拭镜子、整理食物、做饭等等。
如果 Figure 能将这三个任务扩展到 10 到 12 个任务,同时将零样本成功的几率提升到 80% 到 90%,那么我们就离真正能够把机器人部署到家庭中而不需要先收集该家庭的数据不远了。
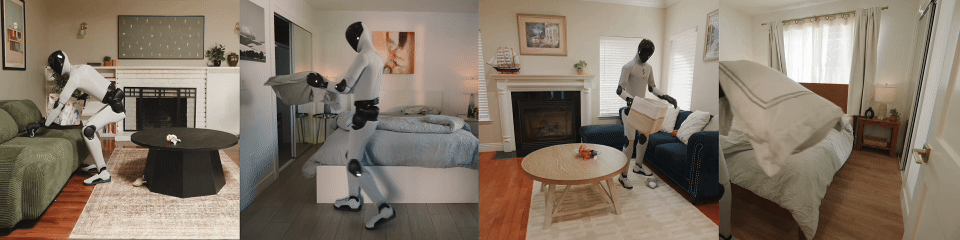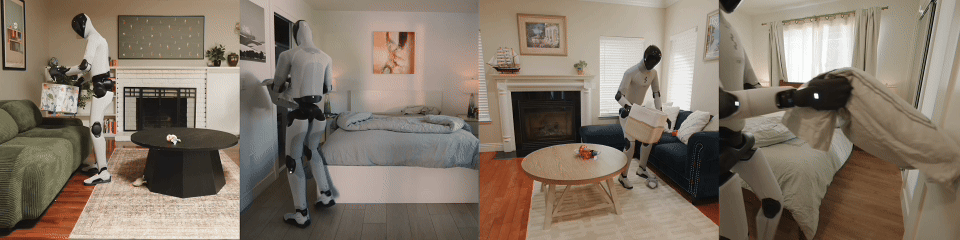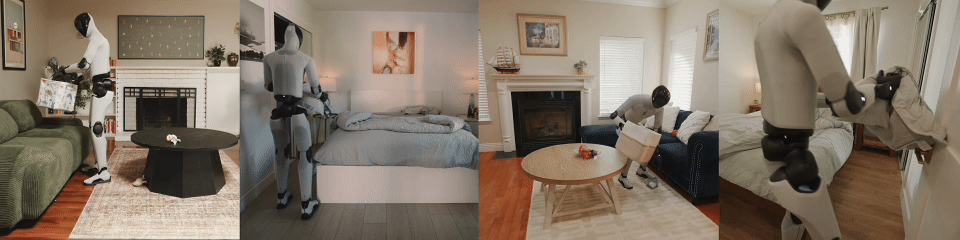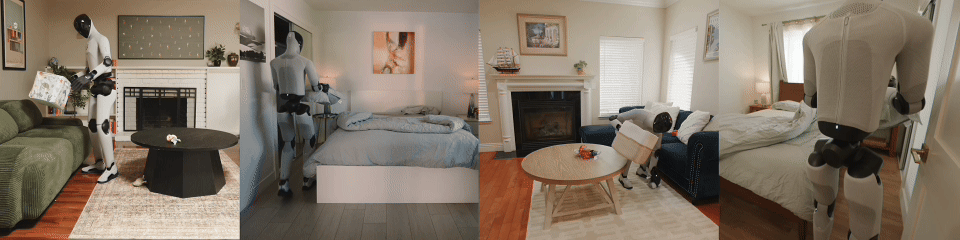
目前 56% 的成功率并不意味着机器人永远都会失败——因为 Helix 2.5 在长时间任务中已经有了自我修正和重试的功能。就像孩子们小时候需要多次尝试才能把床铺整理好一样,机器人也需要多次尝试才能成功完成任务。
租来的住宅提供了不同布局,却未必涵盖日常生活的全部混乱。地毯上的乐高积木,沙发缝里的充电线,孩子临时堆起的玩具,都可能改变原本能够通过的路线。收拾之前先替机器人收拾一遍,显然不符合人们购买它的初衷。
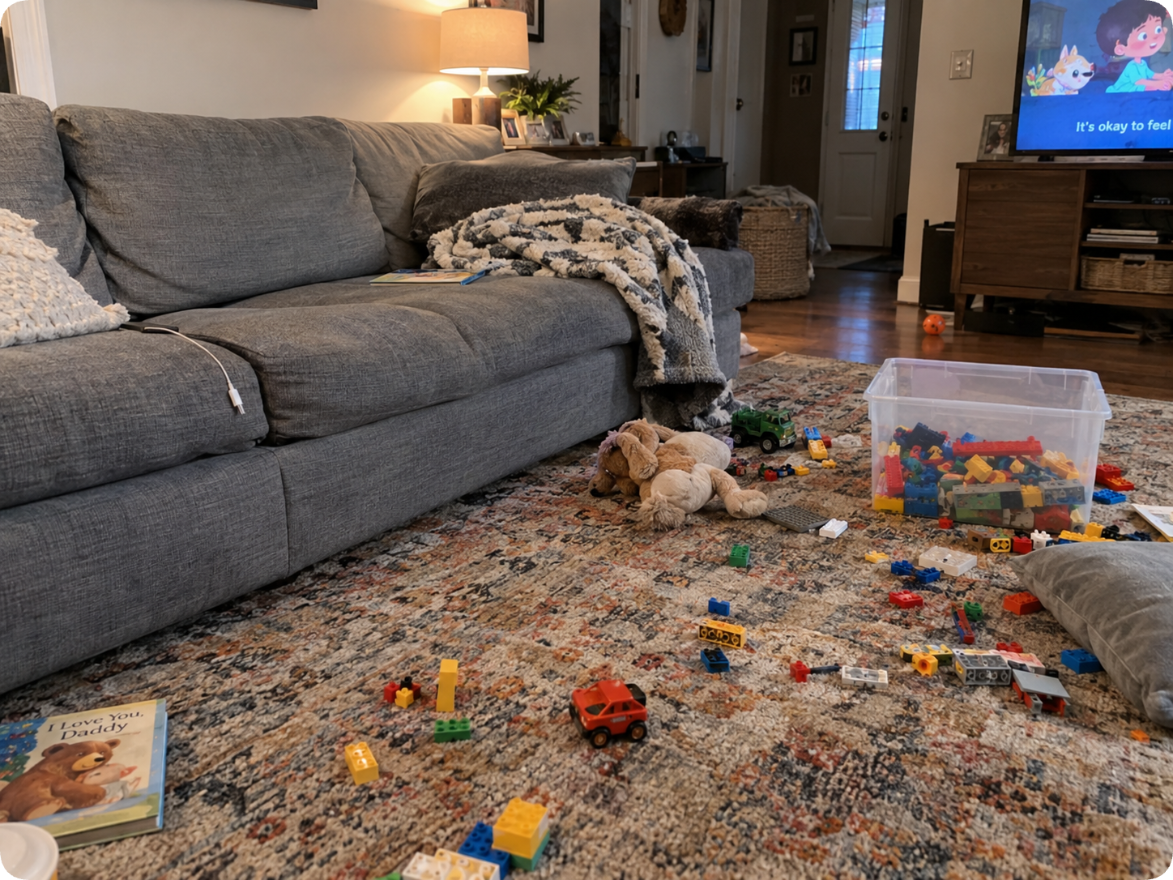
可以设想,如果任务从 3 类增加到 10 至 12 类,成功率提升到 80% 至 90%,会让限定范围的家庭试点更有吸引力。
Figure 正在为扩大训练准备资源。9 月初,云计算公司 Nscale 宣布向 Figure 提供至少 35 亿美元的算力,双方计划把这一规模扩大到 60 亿美元以上,最多部署 10 万块英伟达 Vera Rubin 芯片,首批设备预计 2027 年下半年在得州巴斯托落地;作为交易的一部分,Nscale 还入股 Figure,成为其「优先算力供应商」。
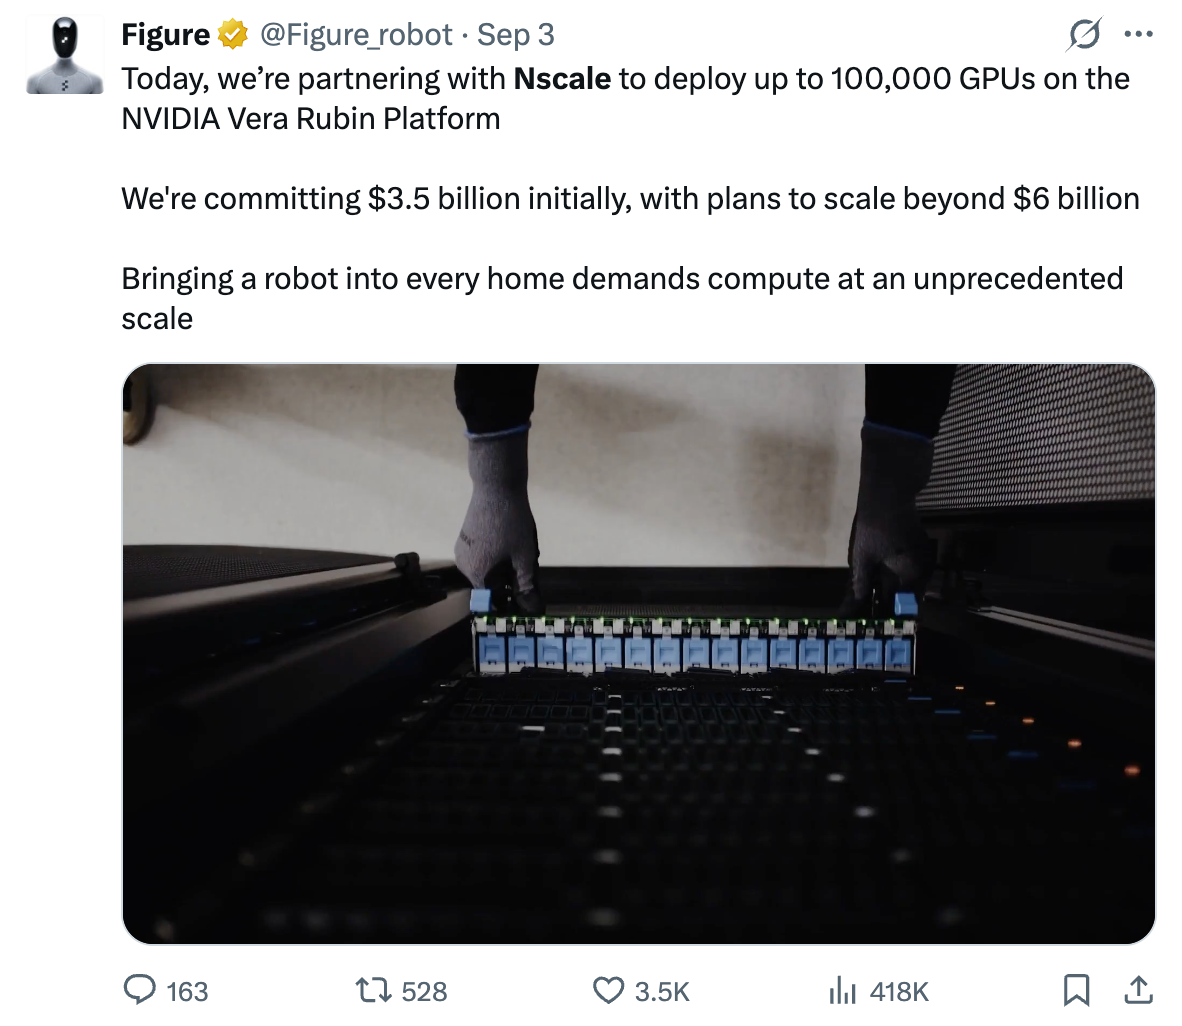
Adcock 在声明中表示,要把人形机器人送进全世界的每一个家庭,公司眼下最大的瓶颈就是数据和算力。
Index 已经在大规模收集人类经验。从 Figure 的报告中可以看出,随着数据量增加,迁移效果会有可预见的提升。需要持续关注的是:在完成几次更大规模的 Index 训练、面对更庞大的任务集合之后,56% 这个数字能被推到多高。
相关参考 :
https://www.figure.ai/news/helix-2-5-zero-shot-30-home-generalization
#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。